生成AIをはじめとするサービスを支えるスーパーコンピュータ。その性能を十分に引き出すには、計算機(ノード)を増やすだけでは足りない。使える電力には上限があり、多数の利用者の処理をどう割り当てるかによって、計算の効率は変わる。さらに、システムを安定して動かすための監視や管理も、計算機に負担をかけている。こうした課題に取り組むのが、東京科学大学 情報理工学院 数理・計算科学系の坂本龍一准教授である。ハードウェアとソフトウェアの両面から、スーパーコンピュータはもちろんデータセンターを効率よく動かす仕組みを研究している。今回は、限られた電力を有効に使う計算の割り当て方や、管理処理を担う通信装置の開発、社会実装に向けた課題について伺った。
消費電力を予測し、計算の割り当てを最適化する
Q : 研究概要について教えてください。
スーパーコンピュータやクラウドシステムなど、大規模なコンピュータシステムを効率よく動かすための研究に取り組んでいます。中でも、スーパーコンピュータでは、与えられた電力の範囲内で、できるだけ多くの計算を行うことを目指しています。
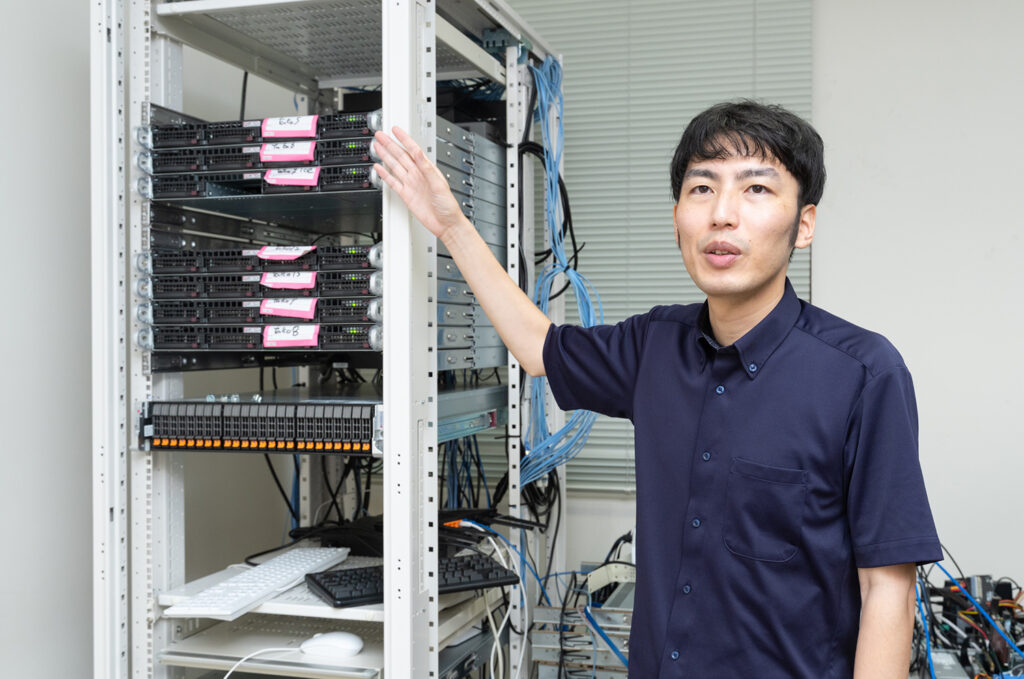
コンピュータの電力というと、消費量を減らして電気代を抑えることをイメージするかもしれません。私が重視しているのは、同じ電力を使うのであれば、その中でこなせる計算を増やすという考え方です。使える電力を有効に活用し、より多くの計算結果を社会に還元したいと考えています。背景には、大規模なシステムを動かすうえで、電力が大きな制約になっていることがあります。例えば、東京科学大学のすずかけ台キャンパスにあるスーパーコンピュータ「TSUBAME4.0」は、240台の計算機で構成されています。AIなどの計算に使うGPUは、1台に4基、全体で960基を搭載しています。
計算機本体を動かし、発生した熱を冷却設備で取り除くには、多くの電力が必要です。大学の公開資料では、TSUBAME4.0の運用時の消費電力は、冷却設備も含めて650〜850kWとされています。例えば、60A(アンペア)で契約している家庭で同時に使える電力は、100V(ボルト)換算でおよそ6kWです。これを目安にすると、約110〜140軒の家が、それぞれ契約上限近くまで一斉に電気を使う規模に相当します。
一方、システムで使える電力には、契約電力などによる上限があります。計算機を増やしても、それらを動かす電力を確保できなければ、性能を十分に活かせません。限られた電力をどの計算に、どのように配分するかが、設備の能力を引き出すうえで重要になるのです。私自身、約10年前から、スーパーコンピュータの電力を有効に使う研究を続けてきました。近年は生成AIの利用が広がり、その重要性がさらに高まっていると感じます。多くの人が生成AIに質問や指示を送るたびに、その裏側では計算が発生しています。限られた設備と電力で、増え続ける処理にどう対応するかは、私たちにとって身近なサービスにも関わる課題になっています。
Q : スーパーコンピュータを効率よく動かすために、どのような仕組みを研究しているのでしょうか?
限られた電力の中で多くの計算を進めるには、どの処理を、いつ、何台で動かすかが重要になります。私たちは、この割り当てを決める「スケジューリング」の仕組みを研究しています。スーパーコンピュータは、多数の計算機をつないだシステムです。その一台一台を「ノード」と呼びます。仕組みとしては皆さんが使うパソコンに近いものですが、高い計算性能を備えたり、故障しにくい構成になっていたりします。
通常は、一人がシステム全体を独占するのではなく、数十人、数百人の利用者が同時に共有します。例えば、1,000台あるうちの10台をある人が1時間使い、同じ時間帯に別の人が20台を使うという形です。大きな体育館の中で、複数のグループがそれぞれ場所を確保して活動しているようなイメージです。
利用者ごとに必要な台数や時間が異なるため、割り当てる順番や組み合わせによって、設備の使われ方は変わります。一部だけが動いて、ほかが空いたままになったり、処理を始めるまでの待ち時間が長くなったりすることもあります。高価な設備の性能を十分に活かすには、こうした空きをできるだけ減らす必要があります。
ただし、空いているノードがあっても、次の処理を動かすための電力に余裕がなければ、実行できません。そこで、空き状況や実行中の処理とともに、システム全体の電力使用量も確認しながら、次の割り当てを考えます。例えば、予定より早く計算が終わった場合には、空いた台数と電力の余裕を踏まえ、別の処理を前倒しできないかを検討します。最初に組んだ予定を状況に応じて調整し、電力の上限を守りながら、設備の空き時間を減らしていくのです。
Q : 限られた電力の中でスケジューリングを行う際、特に難しいのはどのような点ですか。
これから動かすプログラムの消費電力を、事前に予測しなければならないことです。同じノードを使っていても、何を計算するかによって必要な電力は変わります。スマートフォンでも、複雑な3Dゲームを動かすときと、ウェブサイトを読むときとでは、電池の減り方が違いますよね。それと同じです。
私たちは、実行する計算のまとまりを「ジョブ」と呼んでいます。利用者はジョブを実行する際に、必要な台数や利用時間を指定します。これらは割り当ての条件として事前に把握できますが、実際にどれくらい電力を使うかは、動かしてみないと正確にはわかりません。
そこで、すでに動いているジョブの消費電力を確認するとともに、これから動かすジョブの消費電力を予測し、全体で上限内に収まるかを見積もります。少なく見積もりすぎれば、上限を超えるおそれがあります。一方、多めに見積もりすぎると、本来は動かせるジョブまで待たせてしまいます。上限を守りつつ、使える電力を十分に活用できるよう、予測に基づいて割り当てを判断するところが難しいのです。
この予測を支えるのが、実行時に集めた電力データです。多数のノードから得られる情報を記録・保存し、分析に使える形に整える必要があります。予測の方法を考えることに加え、そのもとになるデータを継続的に集め、活用できる環境を整えることにも取り組んでいます。
Q : 消費電力の予測や計算の割り当てには、どのような工夫をしているのでしょうか?
蓄積した実行履歴から、ジョブごとの消費電力の傾向を読み取ります。例えば、ある利用者がこれまで動かしてきたジョブを参考に、今回もどのくらい電力を使いそうかを見積もります。その予測値と、必要な台数や実行時間を組み合わせて、利用予定を立てていきます。割り当て方は、必要な台数と実行時間を積み木の縦と横の長さに見立て、箱の中にできるだけ隙間なく詰めるパズルに似ています。これは「パッキング問題」と呼ばれ、処理の順番や組み合わせを考える際の基本になります。
例えば、使えるノードが4台あり、Aさんは2台、Bさんは4台、Cさんは1台を必要としているとします。どの処理も1時間かかる場合、一つずつ順番に実行すると、合計3時間かかります。一方、Bさんの処理を終えた後に、AさんとCさんの処理を同時に動かせば、全体を2時間で終えられます。このように、順番や組み合わせによって、すべての計算が終わるまでの時間を短縮できるのです。
ここに消費電力の予測値を加え、同時に動かす処理の合計が電力の上限に収まるかも確認します。台数・時間・電力という条件を計算で扱える形に整理したモデルをつくり、それらを満たす最適な割り当て方を見出します。
解き方には、既存の手法を活用しています。条件を数式で表して割り当てを求める「整数計画法」や、配置を変えながら、よりよい組み合わせを探す「焼きなまし法」などです。焼きなまし法は、積み木の入った箱を揺すり、並び方を変えながら収まりのよい配置を探すようなイメージです。ジョブの順番や組み合わせを変えて結果を評価し、ときには一時的に効率が下がる変更も受け入れます。よくなる変更だけを選んでいると、そこから先に改善できない配置にとどまることがあるからです。初めはさまざまな配置を試し、徐々に効率が下がる変更を受け入れにくくしながら、候補を絞っていきます。
こうした手法を検討するうえで大切なのが、割り当ての効率と、予定を立てる計算にかかる時間のバランスです。すべての組み合わせを詳しく調べようとすると、答えを出すまでに時間がかかり、実際の運用に使いにくくなります。電力の上限など、守るべき条件を押さえたうえで問題を単純化し、限られた時間で十分によい割り当てを見つけられるようにしています。
Q : この研究における独自性について教えてください。
私の研究の特徴は、効率のよい割り当て方を考えることに加え、それを実際のシステムで動かすための環境づくりまで、一体として捉えていることです。予測に必要な情報をどう集め、割り当ての判断にどう使うか。計算方法と、それを支える仕組みの両方を考えています。現在は、この考え方を、大規模なシステムでAIの推論処理を効率よく進める研究にも広げようとしています。推論処理とは、学習済みのAIが、入力された質問や指示に応じて回答などを生成する処理です。
例えば、人が質問を入力する場合と、AIが別のAIを繰り返し呼び出して作業を進める場合とでは、依頼の間隔や内容が異なります。こうした違いを踏まえて利用予定を立てるには、誰から、どのような依頼が、どれくらいの頻度で届き、処理にどの程度の時間がかかったのかを把握する必要があります。企業でも取り組みが進んでいる領域ですが、私たちも、実際の利用状況を捉えるところから、予測、割り当てまでをつなぐ仕組みを検討していきたいと考えています。
Q : 最近注力されている研究について、教えてください。
現在、特に力を入れているのは、データセンター向けの通信装置の研究です。サーバー本体と通信装置の役割分担を見直すことで、システム全体の効率を高めようとしています。具体的に着目しているのは、稼働状況を監視する処理です。スーパーコンピュータやデータセンターを安定して運用するには、多数のノードが正常に動いているか、特定の場所に処理が集中していないかを把握する必要があります。
ただ、この監視を本体の計算を担うCPUで行うと、処理能力の一部を使うことになります。そこで、監視や管理に関わる処理の一部を、「スマートNIC」と呼ばれる通信装置に任せる方法を研究しています。NICは、サーバーなどをネットワークにつなぎ、データを送受信するための通信カードです。スマートNICは、そこに計算する機能を備えており、受け取ったデータを装置内で処理して、その結果を本体に渡すことができます。
この機能を活用すれば、システムの状態を把握しながら、CPUは利用者の計算により多くの力を使えるようになります。監視を支える仕組みそのものを効率化し、本来の処理に使える余力を増やすという考え方です。
私はこれまで、回路などのハードウェアと、OSや通信を支えるソフトウェアの両方に関わってきました。その経験を生かし、どの処理を通信装置に任せると効果的なのかを検討しています。それぞれの得意な処理を分担させることで、高速化や電力効率の向上につなげていきたいと考えています。
性能と使いやすさ、安定性を磨き、現場で使い続けられる技術へ
Q : この研究における技術的・産業的課題を教えてください。
大きな課題は、専用の通信装置による性能向上と、現場での使いやすさを両立することです。監視にかかる処理の負担を軽くし、高速化につなげられても、導入に複雑な設定や既存のプログラムの変更が必要であれば、現場で活用するまでに手間がかかります。これまで使ってきた環境に、無理なく取り入れられる形にすることが重要です。
技術的には、既存のソフトウェアとの「互換性」を確保する必要があります。データセンターには、長年使い続けてきたプログラムや運用の仕組みが蓄積されています。それらをできるだけ変更せず、新しい装置の性能を活かせるようにしたいと考えています。具体的には、装置を動かすソフトウェアを既存の仕組みに合わせて細かく調整し、どこまで従来と同じように使えるかを確かめていきます。利用する人が専用の装置に合わせて操作や設定を変えることなく、従来と同じ使い方で、より効率よく処理を進められる。そうした状態を目指しています。
産業的には、実際のデータセンターで求められる安定性や運用上の条件を満たすことが課題です。現場では、サービスを安定して提供し続けられることが重視されます。性能の向上を、安心して導入・運用できる形で届けることが、普及につながると考えています。
現在は、産学連携の取り組みとして、ソフトバンクをはじめ、データセンターを持つ企業の方々とも相談しながら研究を進めています。現場ではどのような使い方が求められ、導入に際して何を確認する必要があるのか。既存の環境との互換性や安定性について意見を交わし、将来のシステムのあり方を検討しています。研究側が考える性能のよさと、運用する側が求める条件をすり合わせることも、実用化に向けた大切な過程です。企業の方々との対話を重ねながら、現場で使い続けられる技術に育てていきたいと考えています。
Q : この分野を目指している学生に伝えたいことはありますか?
自分の専門をしっかりと持ちながら、隣接する分野にも目を向けてほしいですね。一つの分野を深く学ぶことは大切ですが、関連する分野を横断して見ることで、新しい気づきが得られることもあります。私自身、ハードウェアと、OSをはじめとするソフトウェアの両方に関わってきました。「誰もやっていないことに取り組みたい」という思いから、意識して分野をまたぐ道を選んだところがあります。両方を学んだからこそ得られた知見が、今の研究にもつながっています。
また、研究の幅を広げるきっかけになったのが、指導教員や共同研究のプロジェクトで出会った方々とのご縁です。異なる専門を持つ方から学び、新しいテーマに取り組む機会をいただきました。2017年には、共同研究のつながりから、米国のローレンス・リバモア国立研究所に約3カ月留学しました。こうした出会いも、自分の視野を広げる経験になっています。
分野を広げれば、その分、学ぶことも増えます。ただ、最初から幅広い領域を網羅しようとする必要はありません。まずは、自分の専門と関わりの深い分野を一つのぞいてみる。そこで得た知識を自分の研究と結びつけていけば、独自のテーマを見つけやすくなると思います。
Q : 企業との共同研究ではどのようなことを期待していますか?
データセンターや大規模なネットワークシステムを持つ企業の方々と、現場の課題や技術への要望について議論できることを期待しています。私たちが研究している通信装置やシステムの効率化技術を紹介しながら、どのような場面で役立てられるかを一緒に考えていきたいですね。
企業のサーバーやネットワークには、外部に公開されていない情報も多くあります。研究室から見える情報だけでは、実際の運用で何が求められているのかを十分に把握しきれません。企業の方々との対話を通じて、共同研究していくことで、より具体的にしていけると考えています。まずは、公開されている情報や、お話しいただける範囲での意見交換から始められればと思っています。私たちの技術でできることと、現場で求められていることを持ち寄り、研究につながるテーマを見つけていきたいですね。
Q : 今後の展望について教えてください。
スーパーコンピュータやクラウドシステムの電力効率を高め、処理を速くする研究に、引き続き取り組んでいきたいと考えています。普段は利用者から見えにくい部分ですが、AIをはじめ、身近なサービスを支える基盤です。その性能を引き出すことが、日々の使いやすさにもつながります。時代とともに、システムに求められる役割や解決すべき課題も変わっていきます。AIの利用が広がるなかで、どのような処理が増え、何が効率化の妨げになっているのか。実際の使われ方を捉えながら、研究を進めていくことが大切だと思っています。
そのためにも、アプリケーションやサービスを運用している方々との連携を深めていきたいですね。現場で扱われる大規模で複雑なデータや、多様な利用状況には、研究室だけでは再現しきれないものがあります。実際の運用から得られる知見を研究に取り入れ、変化する課題にともに向き合いながら、社会を支えるシステムをより効率よく動かせるようにしていきたいと考えています。(了)
坂本龍一(さかもと・りゅういち)
東京科学大学 情報理工学院 数理・計算科学系 准教授
2010年 東京農工大学 工学部 情報工学科 卒業。2012年 東京農工大学 工学府 情報工学専攻 修了。2015年 東京農工大学 工学府 電子情報工学専攻 修了。2015年から2年間、東京大学大学院 情報理工学系研究科 特任研究員を経験し、2016年 東京大学大学 院情報理工学系研究科 助教。2021年 東京工業大学 学術国際情報センター 准教授、2022年 同大学 情報理工学院 数理・計算科学系 准教授を経て、2024年10月より現職。